Motivos de desvinculación: lo que esconde el motivo declarado
People Analytics
R
Quarto
Rotación
Dos años de desvinculaciones y entrevistas de salida de una cadena de supermercados. Por qué las personas renuncian, dónde se concentra y dónde actuar primero.
Caso ficticio. Cestária Supermercados, sus tiendas, personas y entrevistas no existen. Los datos se generaron desde cero con un script en R, con patrones de tamaño conocido. El método es real.
Descargar el informe (PDF) · Descargar las prioridades por gerencia (CSV)
La pregunta
Cestária es una cadena de supermercados del interior de Minas Gerais, en Brasil, con 8 tiendas (L1 a L8), un centro de distribución (CD) y una oficina central (OC), y cerca de 1.790 personas en la dotación. En 2024 y 2025, 1.453 personas dejaron la empresa.
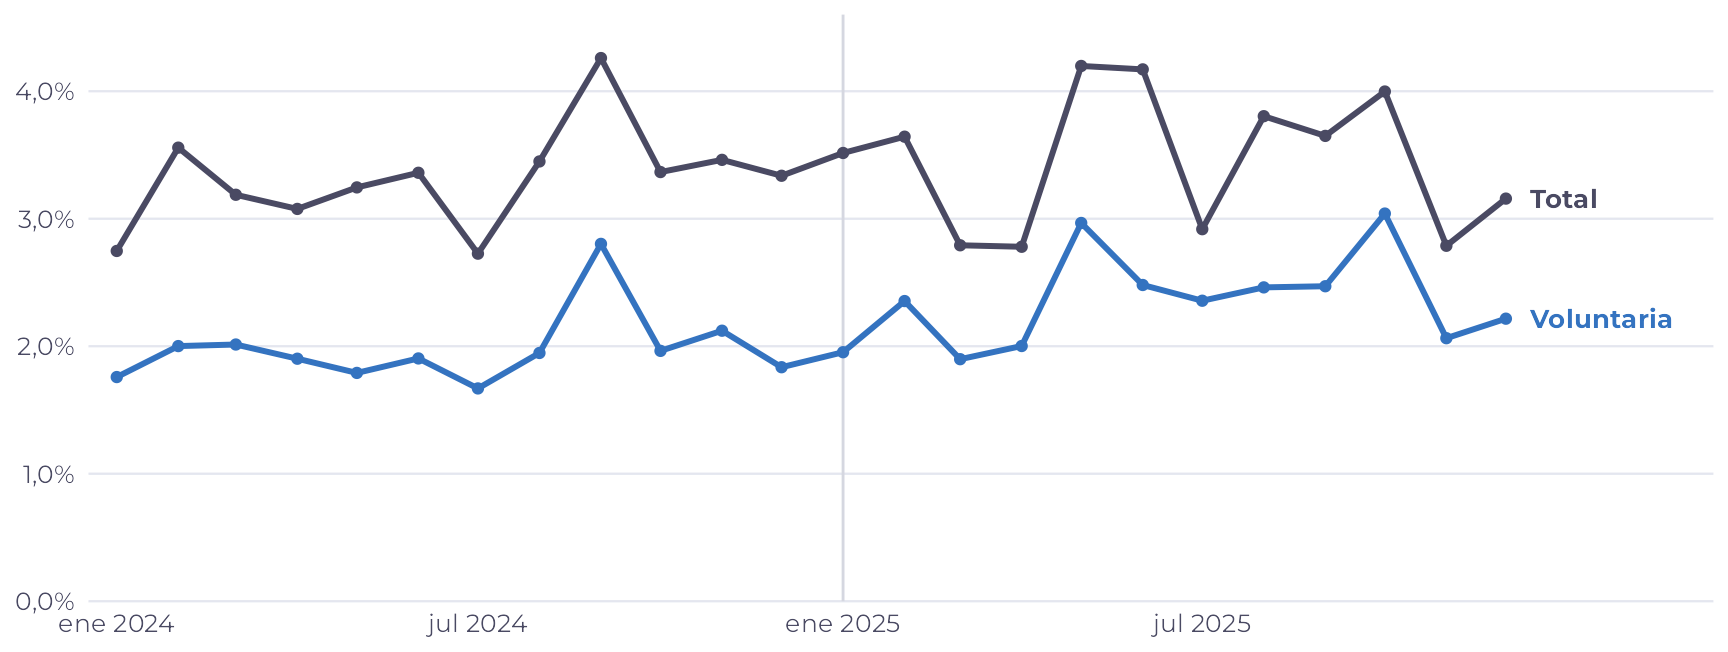
La tasa de desvinculación se mantuvo: en promedio, 3,31% de la dotación salió cada mes en 2024 y 3,45% en 2025, una diferencia compatible con el azar (p = 0,45). La composición, en cambio, sí cambió. Las salidas voluntarias subieron de 1,98% a 2,35% al mes, y los despidos bajaron casi en la misma medida.
Con el total estable, la rotación no parecía un tema. La dirección hizo otras dos preguntas: ¿por qué las personas renuncian?, y ¿dónde actuar primero? Para responder, la entrevista de salida, que la empresa ya hacía y nadie leía junto con lo demás, se cruzó con la dotación mes a mes y con las desvinculaciones.
Lo que muestran los datos
- El motivo declarado esconde el motivo real. “Salario y beneficios” es el motivo más citado por quienes renuncian (25,6%). Entre quienes dieron nota 1 o 2 a su líder, sin embargo, “liderazgo y jefatura” pasa al frente, con 44,5% frente a 20,9%.
- Las salidas en los primeros 90 días crecieron en dos gerencias. En CD Despacho, la parte del personal contratado que renunció hasta los 90 días pasó de 20% en 2024 a 39% en 2025; en L3 Operaciones, de 20% a 41%. En las demás gerencias, la cifra quedó cerca de 17%.
- L5 Ventas empezó a perder más personas tras el cambio de líder, en julio de 2025, y “liderazgo y jefatura” pasó a ser el motivo de 71% de las salidas respondidas desde entonces.
- La escala 6x1 del turno nocturno concentra “jornada y escala”, motivo de 40% de las salidas en ese grupo, frente a 8% en el resto. La escala 6x1 son seis días de trabajo y uno de descanso.
- La edad no explica las salidas. Las personas más jóvenes salen más, pero solo porque tienen menos antigüedad; con la antigüedad en el modelo, la diferencia desaparece.
- La entrevista tiene sesgo de respuesta, más fuerte en las salidas involuntarias y en la L7, pero corregir ese sesgo no cambia el orden de los motivos.
Lo que esconde el motivo declarado
Quien renuncia (renuncia o acuerdo mutuo) responde, en la entrevista, un motivo principal y, si quiere, uno secundario, de una lista cerrada de ocho. Hubo 712 respuestas con motivo en los dos años.
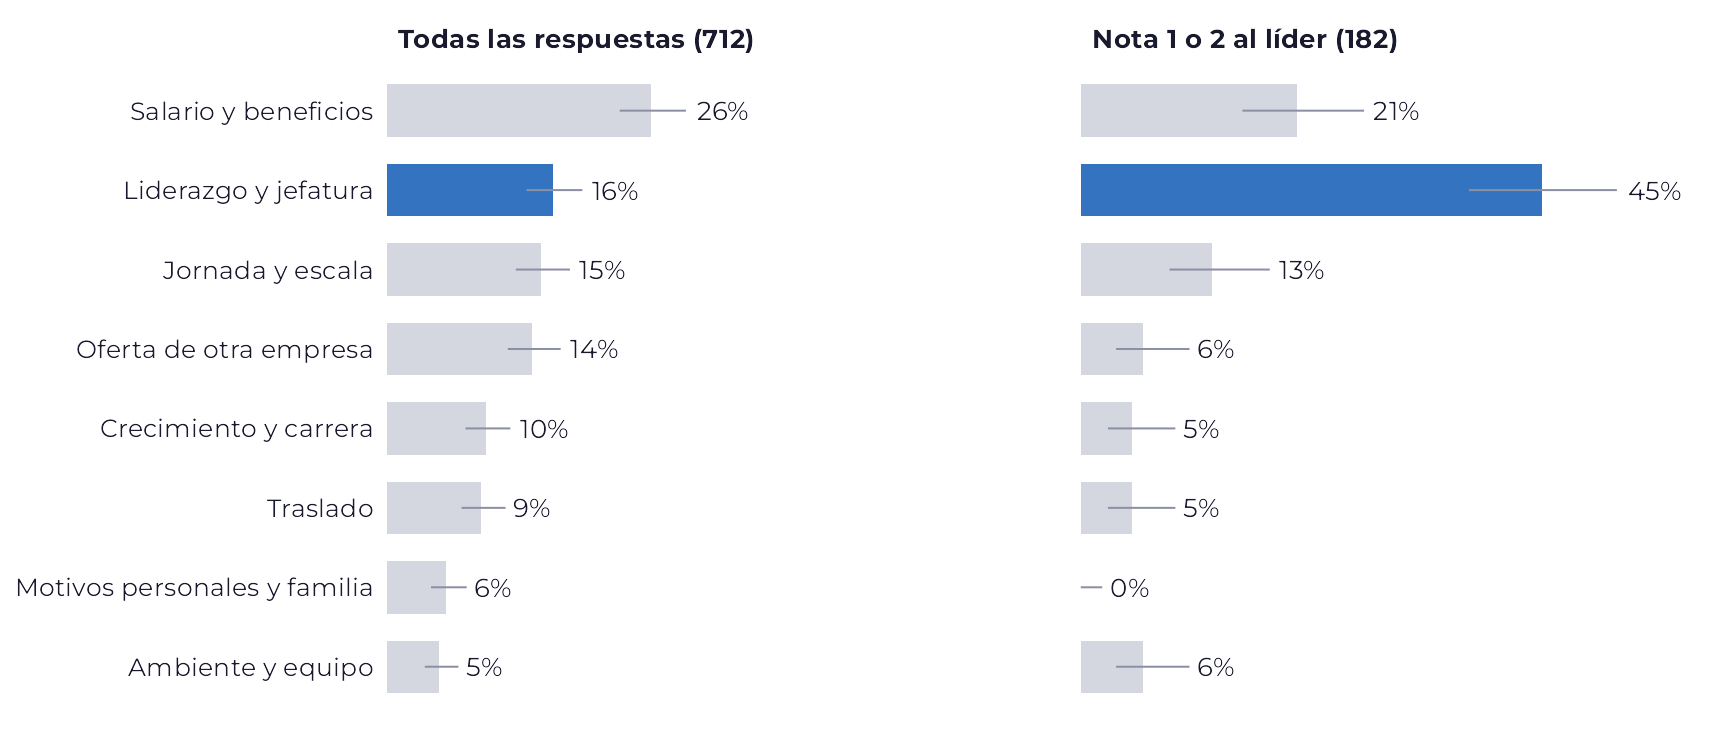
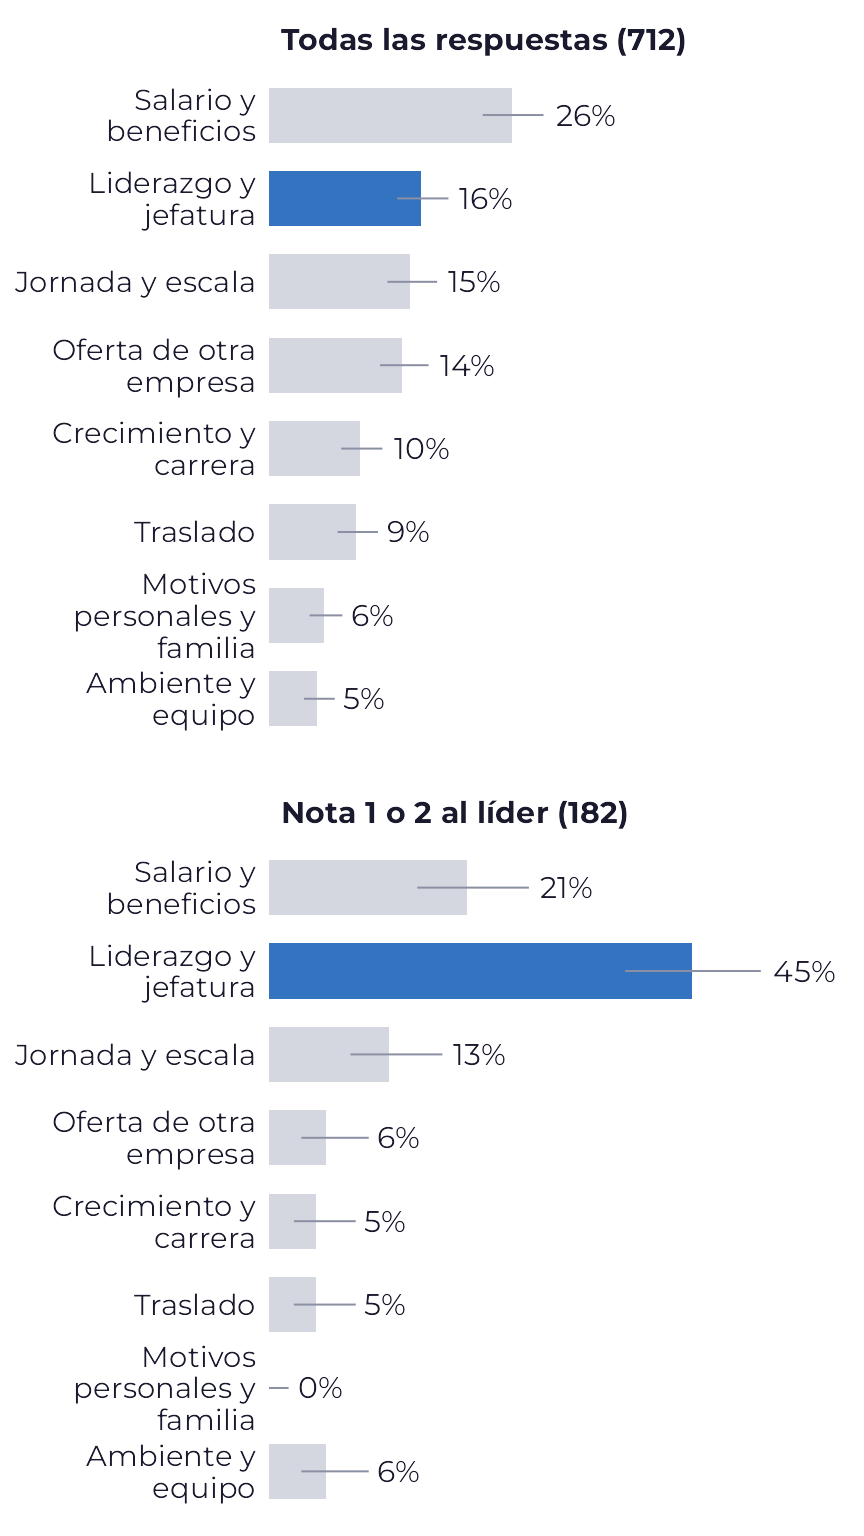
En general, “salario y beneficios” lidera, con 25,6% de las respuestas (IC 95% de 22,5% a 28,9%), y “liderazgo y jefatura” aparece con 16,0%. El panorama cambia entre las 182 personas que dieron nota 1 o 2 al líder: “liderazgo y jefatura” sube a 44,5% (de 37,5% a 51,8%), y el salario baja a 20,9%.
El salario también esconde el liderazgo cuando aparece junto con la nota baja. De las 38 personas que dieron nota 1 o 2 al líder y declararon el salario como motivo principal, 22 (58%) pusieron “liderazgo y jefatura” como motivo secundario. Sumando principal y secundario, 73% de quienes dieron nota baja al líder hablan del liderazgo, frente a 15% entre los demás.
Esto no prueba que el líder haya causado la salida. Muestra que el motivo declarado, leído solo, apunta al salario, mientras que la nota al líder y el motivo secundario apuntan al liderazgo. El salario es la respuesta más fácil de dar en una conversación de salida; por eso la entrevista tiene que leerse con la nota y con el segundo motivo, y no solo por el primero.
Quién respondió la entrevista
La entrevista no es obligatoria. Respondieron 77% de quienes renunciaron y solo 38% de quienes fueron despedidos. Entre las unidades, la L7 queda muy por debajo de las demás, con 37% de respuesta.
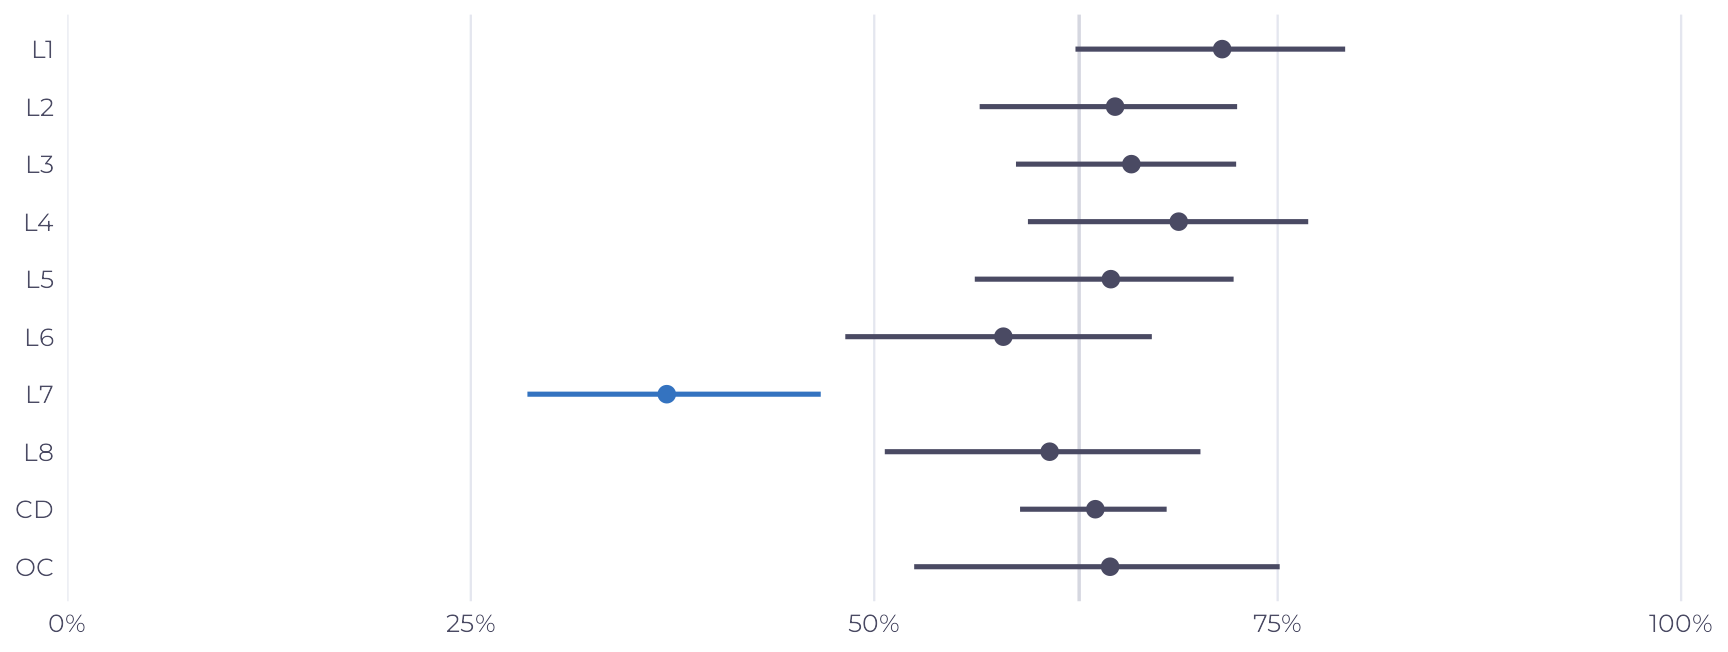
Como el motivo solo se pregunta a quien renuncia, la diferencia entre salidas voluntarias e involuntarias no distorsiona el panorama de los motivos; la diferencia entre unidades, sí. Para ver si cambia la conclusión, cada respuesta se ponderó por la inversa de la tasa de respuesta de su unidad, de modo que la L7 pese lo que pesaría si todos hubieran respondido. Ningún motivo cambió más de 0,3 punto porcentual, y el orden se mantuvo.
| Motivo | Sin ponderación | Ponderado |
|---|---|---|
| Salario y beneficios | 25,6% | 25,6% |
| Liderazgo y jefatura | 16,0% | 15,9% |
| Jornada y escala | 14,9% | 14,9% |
| Oferta de otra empresa | 14,0% | 14,0% |
| Crecimiento y carrera | 9,6% | 9,4% |
| Traslado | 9,1% | 8,9% |
| Motivos personales y familia | 5,8% | 6,0% |
| Ambiente y equipo | 5,1% | 5,2% |
Salario y beneficios
Sin ponderación: 25,6%
Ponderado: 25,6%
Liderazgo y jefatura
Sin ponderación: 16,0%
Ponderado: 15,9%
Jornada y escala
Sin ponderación: 14,9%
Ponderado: 14,9%
Oferta de otra empresa
Sin ponderación: 14,0%
Ponderado: 14,0%
Crecimiento y carrera
Sin ponderación: 9,6%
Ponderado: 9,4%
Traslado
Sin ponderación: 9,1%
Ponderado: 8,9%
Motivos personales y familia
Sin ponderación: 5,8%
Ponderado: 6,0%
Ambiente y equipo
Sin ponderación: 5,1%
Ponderado: 5,2%
La ponderación supone que, dentro de cada unidad, quien respondió se parece a quien no respondió. Si quienes no respondieron en la L7 salieron por motivos distintos de los de quienes respondieron, ningún peso lo corrige; es la primera de las limitaciones del caso.
Dónde actuar primero
Salidas en los primeros 90 días
Entre las 1.222 personas contratadas de enero de 2024 al 02/10/2025, que ya cumplieron 90 días de antigüedad, la parte que renunció hasta el día 90 subió en dos gerencias y se mantuvo en el resto. En CD Despacho, pasó de 20% entre las contrataciones de 2024 a 39% entre las de 2025 (IC 95% de 31% a 48%); en L3 Operaciones, de 20% a 41% (de 26% a 57%). En las demás gerencias, de 15% a 17%.
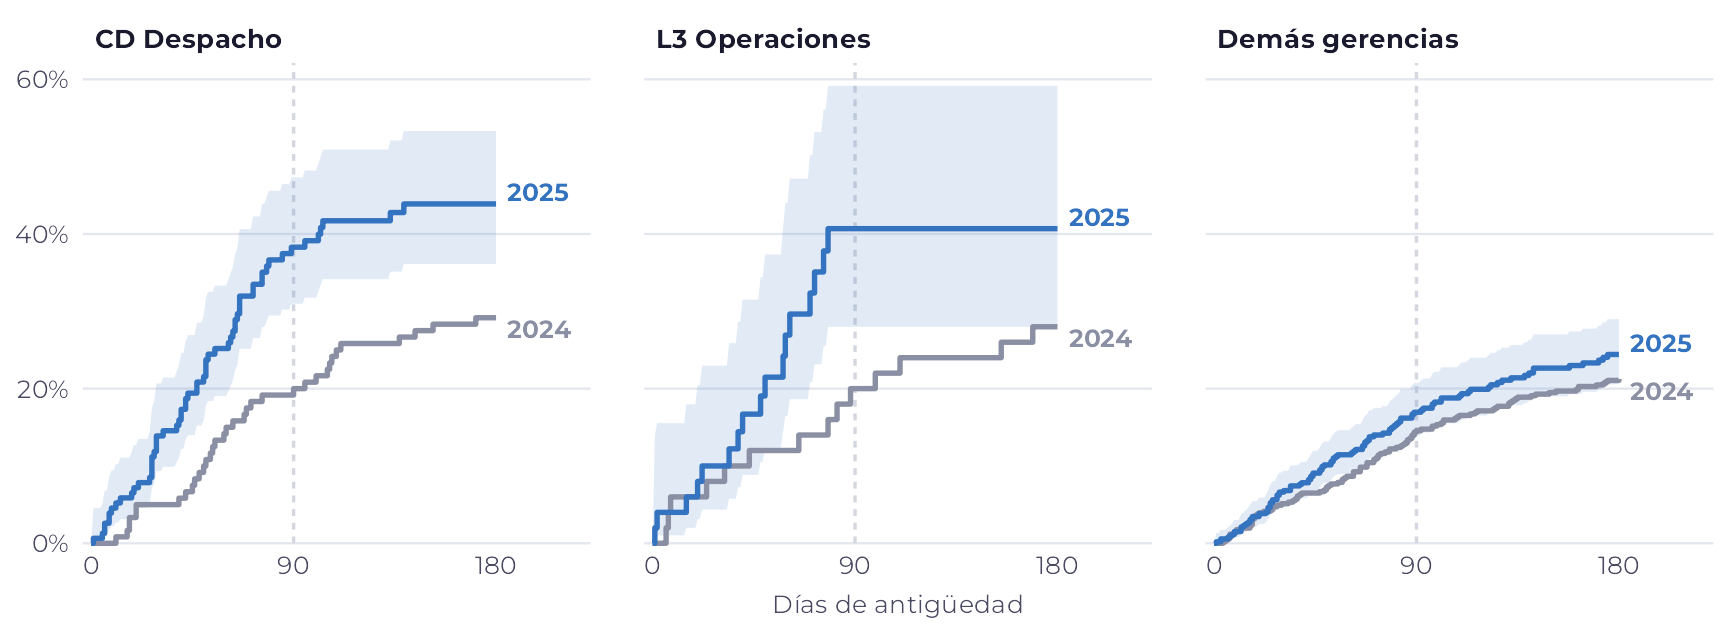
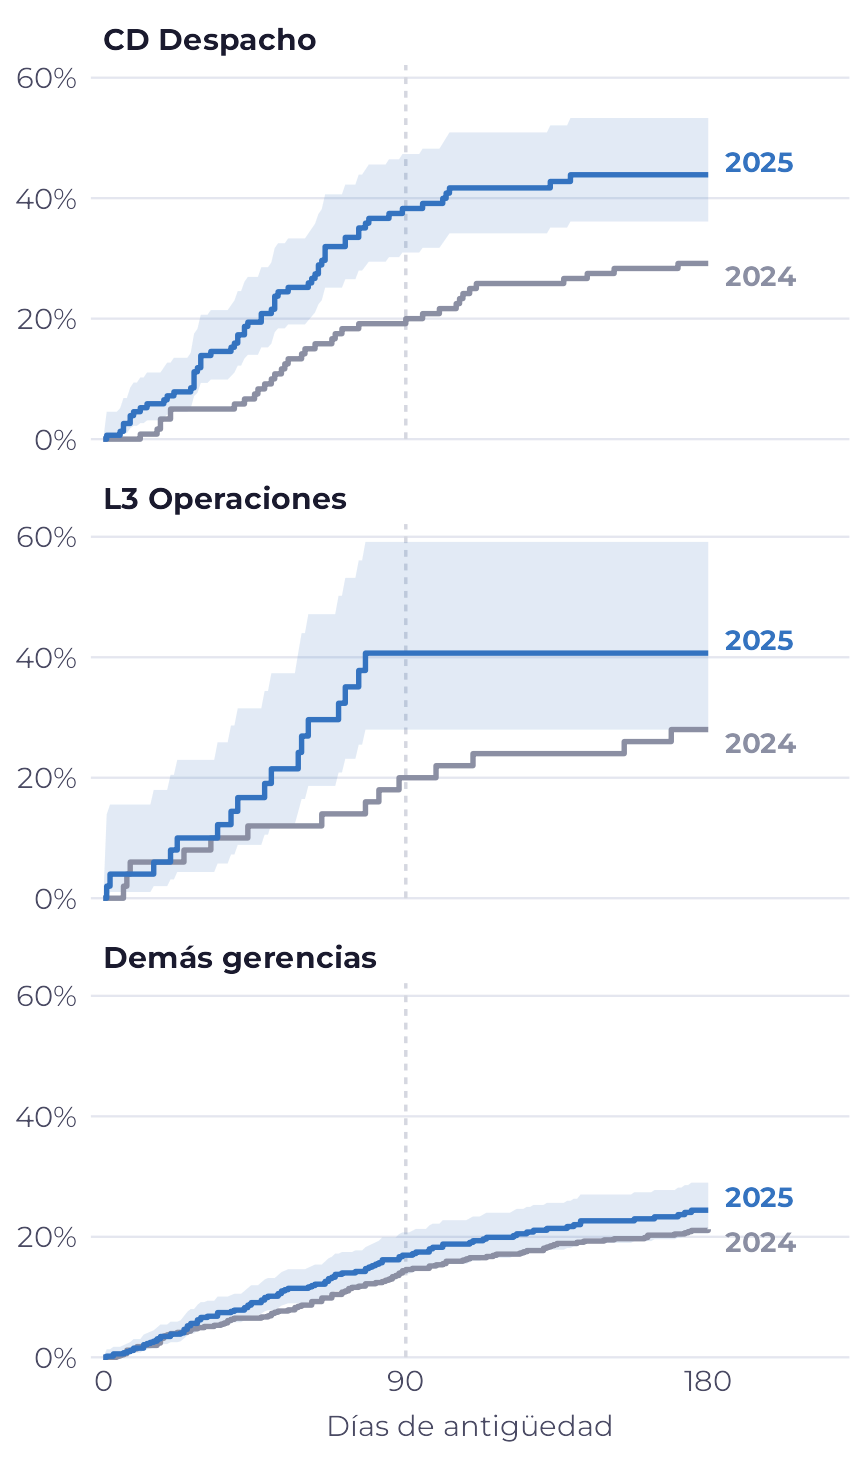
En un modelo de Cox de causa específica solo con las contrataciones de 2025, el riesgo de salida voluntaria fue 2,2 veces el de las demás gerencias en CD Despacho (IC 95% de 1,6 a 3,0) y 2,1 veces en L3 Operaciones (de 1,3 a 3,5).
Salir en los primeros 90 días suele tener más que ver con la llegada que con el mercado: la integración, la escala informada en la contratación, el primer líder. Ninguna de las dos gerencias cambió de líder, y la entrevista de quien sale tan pronto es corta; el siguiente paso es escuchar a las personas contratadas en esas dos áreas antes de que cumplan 90 días.
El cambio de líder en L5 Ventas
L5 Ventas cambió de líder en julio de 2025. Para separar el efecto del cambio de lo que pasó en toda la empresa en el mismo período, la L5 se comparó con las otras siete gerencias de Ventas, que no cambiaron de líder.
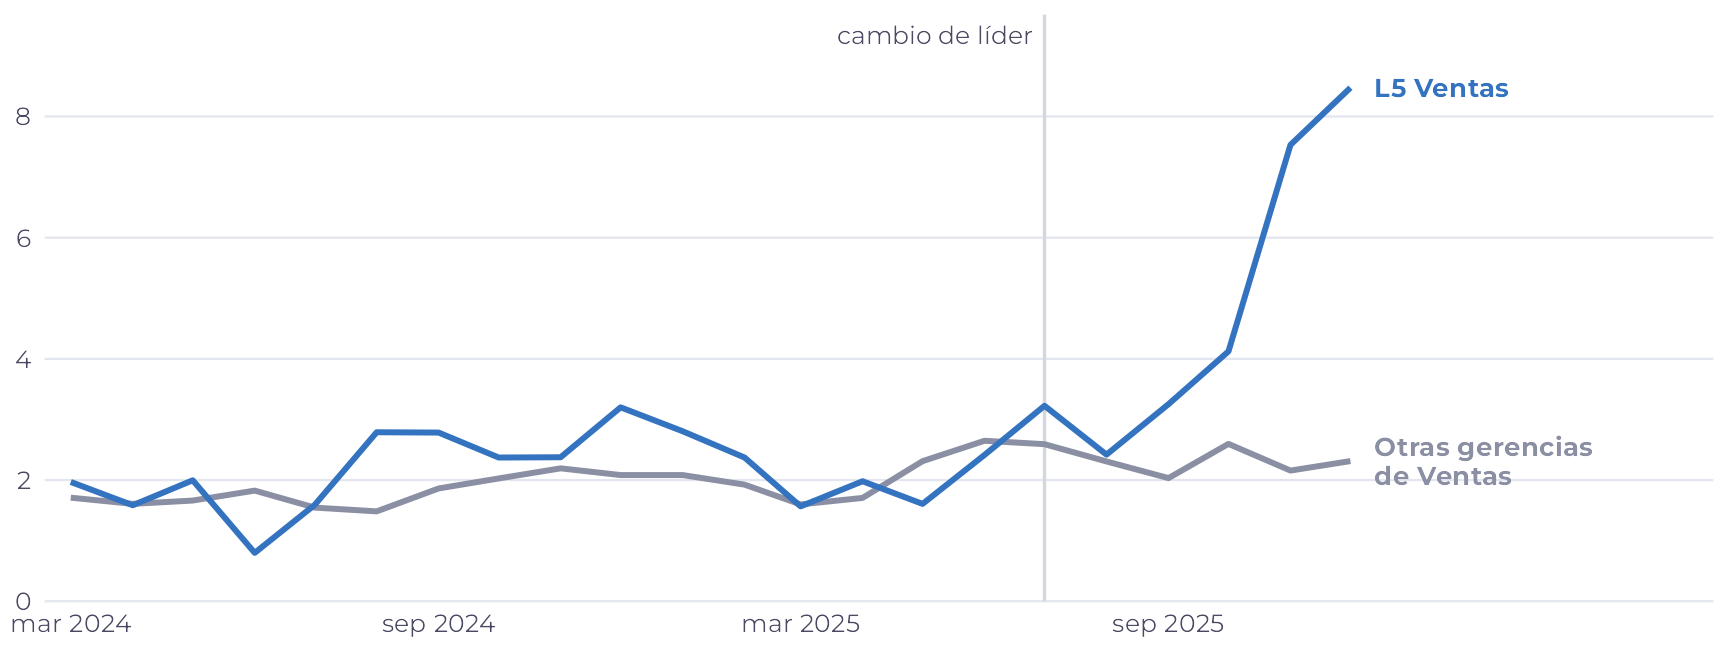
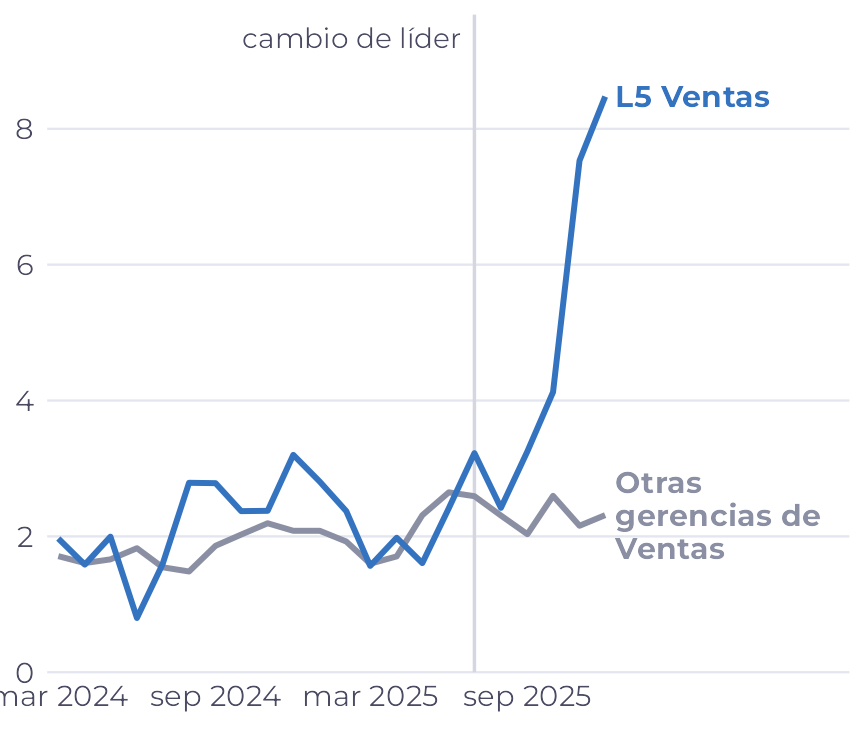
Antes del cambio, la L5 perdía 2,1% de su dotación al mes en salidas voluntarias, y las otras gerencias de Ventas, 2,0%. Después, la L5 pasó a 5,8%, y las otras, a 2,2%. Descontado el cambio de las otras gerencias, la tasa de la L5 quedó 2,5 veces más alta después del cambio de líder (IC 95% de 1,4 a 4,4, modelo de Poisson).
El motivo acompaña: antes del cambio, “liderazgo y jefatura” apareció en menos de 10 de las 25 respuestas de la L5; después, en 17 de las 24 (71%, de 51% a 85%). Es una asociación en el tiempo, y no la prueba de que el nuevo líder sea la causa: son solo seis meses, y otra cosa pudo haber cambiado en la tienda al mismo tiempo. Pero es la señal más fuerte del caso, y la más barata de verificar, en una conversación con el equipo y con el líder.
La escala 6x1 en el turno nocturno
En la escala 6x1 del turno nocturno, que es la de reposición en las tiendas y de parte del CD, “jornada y escala” es el motivo de 40% de las salidas voluntarias respondidas (de 33% a 48%), frente a 8% en las otras combinaciones de turno y escala. La tasa de salida voluntaria también es la más alta: 2,80% del grupo al mes.
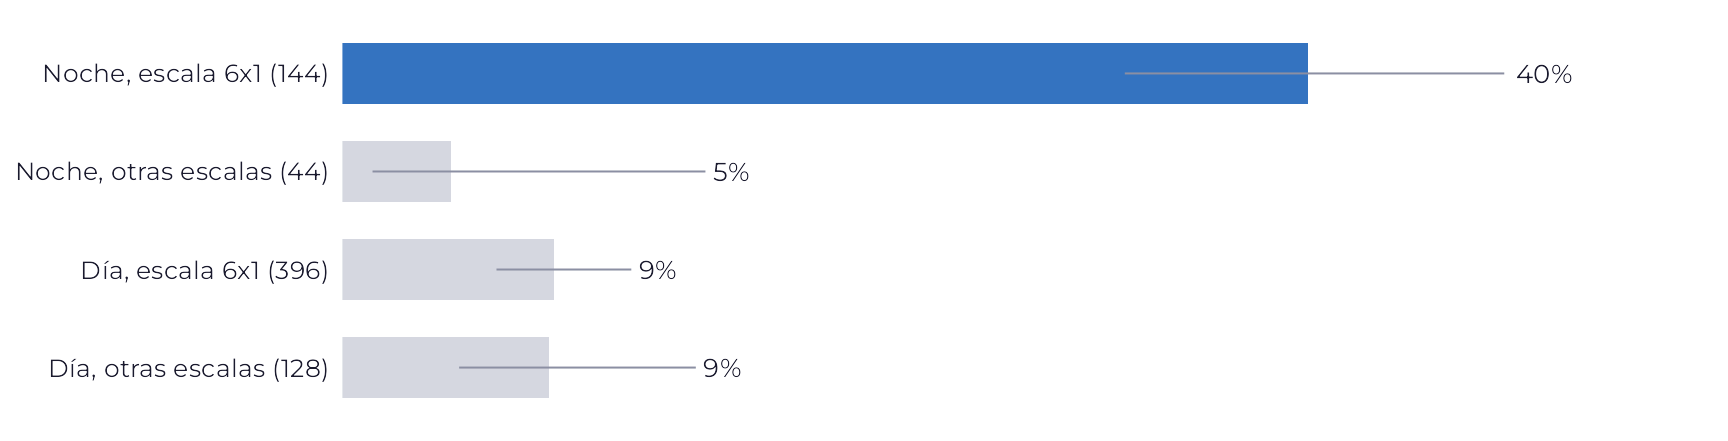
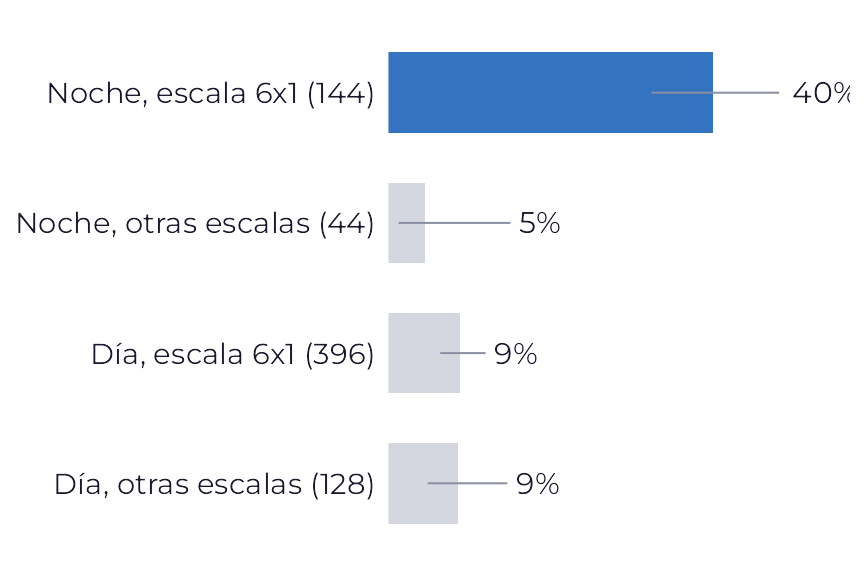
La noche en otras escalas (12x36 en el CD, 5x2 en algunas tiendas) no tiene el mismo problema. Lo que pesa es la combinación de la noche con un solo día libre a la semana, y eso apunta a una decisión de escala, y no de salario.
Prioridades por gerencia
Los tres frentes anteriores se convierten en una lista. En 2025, cada gerencia recibió una prioridad:
- Alta: la tasa de salida voluntaria o la parte del personal contratado que salió hasta los 90 días queda por encima de la empresa incluso en el límite inferior del intervalo de confianza.
- Media: las dos quedan por encima de la empresa en la estimación, o “liderazgo y jefatura” o “jornada y escala” quedan por encima de la empresa en el límite inferior del intervalo.
- Seguimiento: el resto.
Dentro de cada nivel, el orden es el de las salidas voluntarias por encima de lo esperado según la tasa de la empresa. La lista completa, con los intervalos, está en el CSV al inicio de la página; ninguna cifra de un grupo con menos de 10 personas aparece en ella.
La gerencia L2 Operaciones tiene un destacado en “jornada y escala” en el cruce de motivo con gerencia, pero sigue en “Seguimiento”: en 2025, la tasa voluntaria (2,82% al mes) queda por encima de la empresa (2,35%) solo en la estimación, las salidas hasta 90 días (6%) quedan por debajo de la empresa (24%), y la parte de “jornada y escala” entre las respuestas de 2025 no supera a la empresa en el límite inferior del intervalo.
| Orden | Gerencia | Prioridad | Señales | Tasa voluntaria al mes | Salidas hasta 90 días | Respuesta | Liderazgo y jefatura |
|---|---|---|---|---|---|---|---|
| 1 | CD Despacho | Alta | Tasa voluntaria; Salidas hasta 90 días | 3,21% | 39% | 63% | 16% |
| 2 | L5 Ventas | Alta | Tasa voluntaria; Liderazgo y jefatura | 3,85% | 25% | 76% | 55% |
| 3 | L3 Operaciones | Alta | Salidas hasta 90 días | 2,84% | 41% | 57% | 8% |
| 4 | L1 Operaciones | Media | Tasa voluntaria (en la estimación); Salidas hasta 90 días (en la estimación) | 3,60% | 30% | 77% | 6% |
| 5 | L2 Operaciones | Seguimiento | Jornada y escala (cruce con la gerencia) | 2,82% | 6% | 64% | 23% |
| 6 | L3 Ventas | Seguimiento | 2,50% | 19% | 68% | 21% | |
| 7 | L8 Ventas | Seguimiento | 2,42% | 20% | 74% | 26% | |
| 8 | L6 Operaciones | Seguimiento | 2,28% | 24% | 78% | 31% | |
| 9 | L5 Operaciones | Seguimiento | 2,18% | 21% | 54% | <10 | |
| 10 | L4 Ventas | Seguimiento | 2,20% | 29% | 71% | 21% | |
| 11 | L8 Operaciones | Seguimiento | 1,99% | 12% | 60% | <10 | |
| 12 | L1 Ventas | Seguimiento | 2,11% | 17% | 65% | 27% | |
| 13 | L6 Ventas | Seguimiento | 2,11% | 19% | 53% | 7% | |
| 14 | L7 Operaciones | Seguimiento | 1,97% | 21% | 22% | <10 | |
| 15 | L4 Operaciones | Seguimiento | 1,85% | 7% | 84% | 0% | |
| 16 | L2 Ventas | Seguimiento | 2,02% | 13% | 69% | 11% | |
| 17 | L7 Ventas | Seguimiento | 1,58% | 6% | 32% | <10 | |
| 18 | CD Recepción | Seguimiento | 2,01% | 18% | 62% | 8% | |
| 19 | OC Administración | Seguimiento | 0,94% | 4% | 72% | 15% |
1. CD Despacho
Prioridad: Alta
Señales: Tasa voluntaria; Salidas hasta 90 días
Tasa voluntaria al mes: 3,21%
Salidas hasta 90 días: 39%
Respuesta: 63%
Liderazgo y jefatura: 16%
2. L5 Ventas
Prioridad: Alta
Señales: Tasa voluntaria; Liderazgo y jefatura
Tasa voluntaria al mes: 3,85%
Salidas hasta 90 días: 25%
Respuesta: 76%
Liderazgo y jefatura: 55%
3. L3 Operaciones
Prioridad: Alta
Señales: Salidas hasta 90 días
Tasa voluntaria al mes: 2,84%
Salidas hasta 90 días: 41%
Respuesta: 57%
Liderazgo y jefatura: 8%
4. L1 Operaciones
Prioridad: Media
Señales: Tasa voluntaria (en la estimación); Salidas hasta 90 días (en la estimación)
Tasa voluntaria al mes: 3,60%
Salidas hasta 90 días: 30%
Respuesta: 77%
Liderazgo y jefatura: 6%
5. L2 Operaciones
Prioridad: Seguimiento
Señales: Jornada y escala (cruce con la gerencia)
Tasa voluntaria al mes: 2,82%
Salidas hasta 90 días: 6%
Respuesta: 64%
Liderazgo y jefatura: 23%
6. L3 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,50%
Salidas hasta 90 días: 19%
Respuesta: 68%
Liderazgo y jefatura: 21%
7. L8 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,42%
Salidas hasta 90 días: 20%
Respuesta: 74%
Liderazgo y jefatura: 26%
8. L6 Operaciones
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,28%
Salidas hasta 90 días: 24%
Respuesta: 78%
Liderazgo y jefatura: 31%
9. L5 Operaciones
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,18%
Salidas hasta 90 días: 21%
Respuesta: 54%
Liderazgo y jefatura: <10
10. L4 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,20%
Salidas hasta 90 días: 29%
Respuesta: 71%
Liderazgo y jefatura: 21%
11. L8 Operaciones
Prioridad: Seguimiento
Tasa voluntaria al mes: 1,99%
Salidas hasta 90 días: 12%
Respuesta: 60%
Liderazgo y jefatura: <10
12. L1 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,11%
Salidas hasta 90 días: 17%
Respuesta: 65%
Liderazgo y jefatura: 27%
13. L6 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,11%
Salidas hasta 90 días: 19%
Respuesta: 53%
Liderazgo y jefatura: 7%
14. L7 Operaciones
Prioridad: Seguimiento
Tasa voluntaria al mes: 1,97%
Salidas hasta 90 días: 21%
Respuesta: 22%
Liderazgo y jefatura: <10
15. L4 Operaciones
Prioridad: Seguimiento
Tasa voluntaria al mes: 1,85%
Salidas hasta 90 días: 7%
Respuesta: 84%
Liderazgo y jefatura: 0%
16. L2 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,02%
Salidas hasta 90 días: 13%
Respuesta: 69%
Liderazgo y jefatura: 11%
17. L7 Ventas
Prioridad: Seguimiento
Tasa voluntaria al mes: 1,58%
Salidas hasta 90 días: 6%
Respuesta: 32%
Liderazgo y jefatura: <10
18. CD Recepción
Prioridad: Seguimiento
Tasa voluntaria al mes: 2,01%
Salidas hasta 90 días: 18%
Respuesta: 62%
Liderazgo y jefatura: 8%
19. OC Administración
Prioridad: Seguimiento
Tasa voluntaria al mes: 0,94%
Salidas hasta 90 días: 4%
Respuesta: 72%
Liderazgo y jefatura: 15%
Lo que no explica: la edad
Mirando solo la edad, las personas más jóvenes salen más: la probabilidad de que alguien de 18 a 24 años renuncie en un mes es 1,60 veces la de quien tiene de 35 a 44 (IC 95% de 1,33 a 1,94). Pero las personas más jóvenes son, en promedio, las de menor antigüedad, y lo que pesa es la antigüedad: con ella en el modelo, la razón baja a 1,01 (de 0,83 a 1,24), y el rango de edad en su conjunto deja de marcar diferencia (p = 0,40).
Es un hallazgo nulo que importa: una política “para retener a los jóvenes” apuntaría al blanco equivocado. El punto de atención son los primeros meses en la empresa, a cualquier edad.
Limitaciones
- Datos ficticios. Los patrones los plantó un generador, y el análisis los encontró sin leer la clave de respuestas. Con datos reales, las cifras serían otras; el método es el mismo.
- Sesgo de respuesta. La ponderación corrige la diferencia de respuesta entre unidades, pero supone que, dentro de cada unidad, quien respondió se parece a quien no respondió. Eso no se puede verificar con estos datos.
- Asociación no es causa. La comparación de la L5 con las otras gerencias de Ventas supone que, sin el cambio, la L5 habría seguido la misma tendencia que ellas. Con seis meses después del cambio, el intervalo todavía es amplio.
- Motivo declarado. La lista es cerrada, y cada persona elige un motivo principal; es lo que dice, y no necesariamente lo que pesó.
- Ventana de 90 días. Las contrataciones posteriores al 02/10/2025 quedan fuera de esa cuenta, porque todavía no completaron la ventana.
- Muchas comparaciones. En el cruce de motivo con gerencia, solo cuentan como destacados los residuos ajustados con valor absoluto de 3 o más.
Método
Los pasos están en el código, con el fragmento de cada uno plegado; las tablas técnicas quedan al final de la sección.
- Clasificar las salidas. Voluntaria es la renuncia; involuntaria, el despido sin justa causa y el fin del período de prueba. El acuerdo mutuo es una categoría propia y cuenta como voluntaria en la división en dos (930 voluntarias y 523 involuntarias en los dos años).
- Tasa de desvinculación. Desvinculaciones del mes ÷ dotación media del mes, donde la dotación media es el promedio entre la dotación del primer y del último día. La fórmula clásica de rotación usa en el numerador el promedio entre contrataciones y desvinculaciones. En el año, las dos dan casi lo mismo: la tasa de desvinculación fue de 39,8% en 2024 y 41,4% en 2025, y la rotación clásica, de 38,8% y 41,3%. Los intervalos de las tasas son exactos de Poisson, por persona-mes.
- Salidas hasta 90 días. Entre las personas contratadas de enero de 2024 al 02/10/2025 (1.222), quienes renunciaron hasta el día 90 de antigüedad. Quien fue despedido antes de los 90 días cuenta como “no renunció”.
- Motivos. Pareto del motivo principal entre quienes renunciaron y respondieron, en general y con nota 1 o 2 al líder; proporciones con intervalo de Wilson.
- Tasa de respuesta y ponderación. Tasa de respuesta por tipo de salida y por unidad, y el Pareto ponderado por la inversa de la tasa de respuesta de la unidad.
- Motivo × gerencia. Chi cuadrado de independencia (115,1 con 90 grados de libertad), con los tres motivos menos citados juntos en “otros motivos” y el p calculado por simulación (p = 0,035), porque 56% de las celdas tienen frecuencia esperada menor que 5. Destacados solo para residuos ajustados con valor absoluto de 3 o más: L5 Ventas en “liderazgo y jefatura” (4,9) y L2 Operaciones en “jornada y escala” (3,0).
- Incidencia acumulada y Cox de causa específica. Tiempo desde el día de la contratación hasta la salida, para las personas contratadas en 2024 y 2025, con la salida involuntaria como riesgo competitivo (estimador de Aalen-Johansen,
survfitdel paquete survival con el estado como factor). En lugar de la prueba de Gray, que exige un paquete que no está instalado, un modelo de Cox de causa específica: la gerencia en su conjunto está asociada al riesgo de salida voluntaria (prueba de razón de verosimilitud, 62,5 con 18 grados de libertad, p < 0,001). - Cambio de líder. Salidas voluntarias por gerencia de Ventas y mes, con la exposición en persona-mes, en un modelo de Poisson con la gerencia, el período (antes o después de julio de 2025) y la interacción de la L5 con el período posterior al cambio (diferencia en diferencias). El modelo binomial negativo entraría si la dispersión pasara de 1,2; fue de 0,96.
- Regresión logística. Renuncia hasta los 90 días, con el grupo de gerencia, el año de contratación y la interacción de los dos, la noche en la escala 6x1 y el rango de edad.
- Confusión por la edad. Regresión logística por persona-mes de la renuncia en el mes, con el rango de edad solo y después con el rango de antigüedad.
- Prioridades. Los criterios de la sección anterior, aplicados a 2025, con las cifras de grupos con menos de 10 personas reemplazadas por “<10”.
Ver el código R: tasa de desvinculación
# Taxa de desligamento do mês: desligamentos ÷ headcount médio, em que o
# headcount médio é a média entre o quadro do primeiro e do último dia.
# A fórmula clássica de turnover usa a média entre admissões e desligamentos
# no numerador; as duas aparecem no método.
mensal <- pessoa_mes |>
  group_by(ano_mes) |>
  summarise(hc_medio = sum(peso), admissoes = sum(admitido_no_mes), .groups = "drop") |>
  left_join(saidas |> count(ano_mes, name = "desligamentos"), "ano_mes") |>
  left_join(saidas |> filter(voluntaria) |> count(ano_mes, name = "voluntarios"), "ano_mes") |>
  mutate(across(c(desligamentos, voluntarios), \(x) coalesce(x, 0L)),
         taxa = 100 * desligamentos / hc_medio, taxa_vol = 100 * voluntarios / hc_medio,
         turnover_classico = 100 * (admissoes + desligamentos) / 2 / hc_medio)

anual <- mensal |>
  group_by(ano = as.integer(substr(ano_mes, 1, 4))) |>
  summarise(exposicao = sum(hc_medio), hc_medio = exposicao / n(), desligamentos = sum(desligamentos),
            voluntarios = sum(voluntarios), involuntarios = desligamentos - voluntarios,
            admissoes = sum(admissoes), .groups = "drop") |>
  # Taxa mensal média (por pessoa-mês) e taxa do ano (desligamentos do ano ÷
  # headcount médio do ano).
  mutate(taxa_ano = 100 * desligamentos / hc_medio, taxa_vol_ano = 100 * voluntarios / hc_medio,
         taxa = 100 * desligamentos / exposicao,
         taxa_inf = taxa_ic(desligamentos, exposicao, "inf"), taxa_sup = taxa_ic(desligamentos, exposicao, "sup"),
         taxa_vol = 100 * voluntarios / exposicao,
         taxa_vol_inf = taxa_ic(voluntarios, exposicao, "inf"), taxa_vol_sup = taxa_ic(voluntarios, exposicao, "sup"),
         taxa_inv = 100 * involuntarios / exposicao,
         turnover_classico = 100 * (admissoes + desligamentos) / 2 / exposicao,
         turnover_classico_ano = 100 * (admissoes + desligamentos) / 2 / hc_medio)
teste_anos <- poisson.test(anual$desligamentos, anual$exposicao)

tipos <- saidas |> count(tipo) |> mutate(pct = 100 * n / sum(n))
Ver el código R: salidas hasta 90 días
# Saídas voluntárias até 90 dias, entre os admitidos no período. Ficam fora os
# admitidos depois de 02/10/2025, que ainda não completaram a janela. Quem foi
# dispensado antes dos 90 dias conta como "não saiu voluntariamente".
coorte <- colaborador |>
  filter(data_admissao >= as.Date("2024-01-01")) |>
  left_join(pessoa_mes |> distinct(id_colaborador, gerencia, unidade) |> distinct(id_colaborador, .keep_all = TRUE),
            "id_colaborador") |>
  left_join(deslig |> select(id_colaborador, data_desligamento, tipo), "id_colaborador") |>
  mutate(ano_admissao = year(data_admissao),
         dias = as.integer(coalesce(data_desligamento, FIM) - data_admissao),
         vol_90 = !is.na(tipo) & tipo %in% VOLUNTARIOS & dias <= 90,
         noite_6x1 = turno == "Noite" & escala == "6x1",
         grupo = if_else(gerencia %in% c("L3 Operações", "CD Expedição"), gerencia, "Demais gerências"))
coorte_90 <- coorte |> filter(data_admissao <= JANELA_90)

noventa_ano <- coorte_90 |>
  group_by(ano_admissao) |>
  summarise(admitidos = n(), saidas = sum(vol_90), .groups = "drop") |>
  mutate(pct = 100 * saidas / admitidos, inf = wilson(saidas, admitidos, "inf"), sup = wilson(saidas, admitidos, "sup"))
noventa_gerencia <- coorte_90 |>
  group_by(gerencia, ano_admissao) |>
  summarise(admitidos = n(), saidas = sum(vol_90), .groups = "drop") |>
  mutate(pct = 100 * saidas / admitidos, inf = wilson(saidas, admitidos, "inf"), sup = wilson(saidas, admitidos, "sup"),
         gerencia = factor(gerencia, ordem_gerencias))
# Diferença 2025 menos 2024 em cada gerência: as duas que mais sobem.
subida_90 <- noventa_gerencia |>
  select(gerencia, ano_admissao, pct, admitidos) |>
  pivot_wider(names_from = ano_admissao, values_from = c(pct, admitidos)) |>
  mutate(diferenca = pct_2025 - pct_2024) |>
  arrange(desc(diferenca))
noventa_grupo <- coorte_90 |>
  group_by(grupo, ano_admissao) |>
  summarise(admitidos = n(), saidas = sum(vol_90), .groups = "drop") |>
  mutate(pct = 100 * saidas / admitidos, inf = wilson(saidas, admitidos, "inf"), sup = wilson(saidas, admitidos, "sup"))
Ver el código R: motivos
# Motivo declarado: só quem pediu para sair (pedido ou acordo) e respondeu.
# Pareto geral e entre quem deu nota 1 ou 2 ao gestor.
respondentes <- saidas |> filter(voluntaria, respondeu == "Sim", !is.na(motivo_principal))
pareto <- function(d) {
  d |>
    count(motivo = motivo_principal) |>
    complete(motivo = MOTIVOS, fill = list(n = 0)) |>
    mutate(total = sum(n), pct = 100 * n / total, inf = wilson(n, total, "inf"), sup = wilson(n, total, "sup")) |>
    arrange(desc(n))
}
pareto_geral <- pareto(respondentes)
nota_baixa <- respondentes |> filter(nota_gestor <= 2)
pareto_nota_baixa <- pareto(nota_baixa)
# Quem declarou salário e deu nota baixa ao gestor: quantos põem a liderança
# como motivo secundário.
salario_nota_baixa <- nota_baixa |>
  filter(motivo_principal == "Salário e benefícios") |>
  summarise(n = n(), lideranca_secundario = sum(motivo_secundario %in% "Liderança e gestor")) |>
  mutate(pct = 100 * lideranca_secundario / n, inf = wilson(lideranca_secundario, n, "inf"),
         sup = wilson(lideranca_secundario, n, "sup"))
# Liderança citada como motivo principal ou secundário.
lideranca_qualquer <- respondentes |>
  mutate(nota_baixa = nota_gestor <= 2,
         lideranca = motivo_principal == "Liderança e gestor" | motivo_secundario %in% "Liderança e gestor") |>
  group_by(nota_baixa) |>
  summarise(n = n(), x = sum(lideranca), .groups = "drop") |>
  mutate(pct = 100 * x / n, inf = wilson(x, n, "inf"), sup = wilson(x, n, "sup"))
Ver el código R: tasa de respuesta y ponderación
# Taxa de resposta da entrevista e ponderação pela inversa da taxa de resposta.
resposta_tipo <- saidas |>
  group_by(voluntaria) |>
  summarise(saidas = n(), responderam = sum(respondeu == "Sim"), .groups = "drop") |>
  mutate(pct = 100 * responderam / saidas, inf = wilson(responderam, saidas, "inf"),
         sup = wilson(responderam, saidas, "sup"))
resposta_unidade <- saidas |>
  group_by(unidade) |>
  summarise(saidas = n(), responderam = sum(respondeu == "Sim"), .groups = "drop") |>
  mutate(pct = 100 * responderam / saidas, inf = wilson(responderam, saidas, "inf"),
         sup = wilson(responderam, saidas, "sup"),
         unidade = factor(unidade, unique(estrutura$unidade)))
# Peso de cada resposta voluntária: saídas voluntárias da unidade ÷ respostas
# voluntárias da unidade. Supõe que, dentro de cada unidade, quem respondeu é
# parecido com quem não respondeu.
pesos <- saidas |>
  filter(voluntaria) |>
  group_by(unidade) |>
  summarise(peso = n() / sum(respondeu == "Sim" & !is.na(motivo_principal)), .groups = "drop")
pareto_ponderado <- respondentes |>
  left_join(pesos, "unidade") |>
  group_by(motivo = motivo_principal) |>
  summarise(peso = sum(peso), .groups = "drop") |>
  mutate(pct = 100 * peso / sum(peso)) |>
  right_join(pareto_geral |> select(motivo, pct_sem_peso = pct), "motivo") |>
  mutate(pct = coalesce(pct, 0), diferenca = pct - pct_sem_peso) |>
  arrange(desc(pct))
Ver el código R: motivo × gerencia
# Motivo × gerência: qui-quadrado com p por simulação (mesmo agrupando, há
# células com frequência esperada pequena) e resíduos ajustados. Os três
# motivos menos citados viram "Outros motivos". Só |resíduo| >= 3 é destaque,
# por causa das muitas comparações.
MOTIVOS_QUI <- c(MOTIVOS[1:4], "Crescimento e carreira", "Outros motivos")
motivo_qui <- if_else(respondentes$motivo_principal %in% MOTIVOS_QUI, respondentes$motivo_principal, "Outros motivos")
tabela_mg <- table(factor(respondentes$gerencia, ordem_gerencias), factor(motivo_qui, MOTIVOS_QUI))
qui <- suppressWarnings(chisq.test(tabela_mg, simulate.p.value = TRUE, B = 20000))
qui_assint <- suppressWarnings(chisq.test(tabela_mg))
residuos <- as_tibble(as.table(qui$stdres), .name_repair = ~ c("gerencia", "motivo", "residuo")) |>
  left_join(as_tibble(tabela_mg, .name_repair = ~ c("gerencia", "motivo", "n")), c("gerencia", "motivo")) |>
  mutate(destaque = abs(residuo) >= 3)
Ver el código R: incidencia acumulada y Cox
# Incidência acumulada da saída voluntária com a involuntária como risco
# competitivo (Aalen-Johansen), entre os admitidos no período, até 180 dias.
coorte_ce <- coorte |>
  mutate(evento = factor(case_when(is.na(tipo) ~ "censura", tipo %in% VOLUNTARIOS ~ "voluntária",
                                   TRUE ~ "involuntária"), c("censura", "voluntária", "involuntária")),
         dias = pmax(dias, 0.5))
aj <- survfit(Surv(dias, evento) ~ grupo + ano_admissao, data = coorte_ce)
incidencia <- {
  s <- summary(aj, times = 0:180, extend = TRUE)
  col <- which(s$states == "voluntária")
  tibble(estrato = as.character(s$strata), dias = s$time, inc = 100 * s$pstate[, col],
         inf = 100 * s$lower[, col], sup = 100 * s$upper[, col]) |>
    mutate(grupo = str_match(estrato, "grupo=([^,]+)")[, 2],
           ano_admissao = as.integer(str_match(estrato, "ano_admissao=(\\d+)")[, 2]))
}
incidencia_90 <- incidencia |> filter(dias == 90)
# Cox causa-específico (a saída involuntária vira censura): teste global da
# gerência, no lugar do log-rank, e razão de riscos dos dois grupos em 2025.
cox_global <- coxph(Surv(dias, evento == "voluntária") ~ gerencia, data = coorte_ce)
teste_gerencia <- anova(cox_global)
cox_2025 <- coxph(Surv(dias, evento == "voluntária") ~ relevel(factor(grupo), "Demais gerências"),
                  data = filter(coorte_ce, ano_admissao == 2025))
hr_2025 <- broom::tidy(cox_2025, exponentiate = TRUE, conf.int = TRUE) |>
  mutate(grupo = sub(".*\\)", "", term)) |>
  select(grupo, hr = estimate, inf = conf.low, sup = conf.high, p = p.value)
Ver el código R: cambio de líder
# L5 Vendas troca de gestor em julho de 2025. Comparação de antes e depois com
# as outras sete gerências de Vendas como controle: saídas voluntárias por
# pessoa-mês, com modelo binomial negativo (diferença em diferenças).
vendas <- pessoa_mes |>
  filter(area == "Vendas") |>
  group_by(gerencia, ano_mes) |>
  summarise(hc = sum(peso), .groups = "drop") |>
  left_join(saidas |> filter(voluntaria, area == "Vendas") |> count(gerencia, ano_mes, name = "vol"),
            c("gerencia", "ano_mes")) |>
  mutate(vol = coalesce(vol, 0L), depois = as.Date(paste0(ano_mes, "-01")) >= TROCA,
         troca = gerencia == gerencia_troca, troca_depois = troca & depois)
# Poisson primeiro; se a dispersão passar de 1,2, binomial negativo.
formula_troca <- vol ~ gerencia + depois + troca_depois + offset(log(hc))
modelo_troca <- glm(formula_troca, family = poisson, data = vendas)
dispersao <- sum(residuals(modelo_troca, type = "pearson")^2) / df.residual(modelo_troca)
if (dispersao > 1.2) modelo_troca <- MASS::glm.nb(formula_troca, data = vendas)
rr_troca <- {
  b <- coef(summary(modelo_troca))["troca_depoisTRUE", ]
  tibble(rr = exp(b[["Estimate"]]), inf = exp(b[["Estimate"]] - 1.96 * b[["Std. Error"]]),
         sup = exp(b[["Estimate"]] + 1.96 * b[["Std. Error"]]), p = b[[4]], dispersao = dispersao,
         modelo = if (dispersao > 1.2) "binomial negativo" else "Poisson")
}
troca_taxas <- vendas |>
  group_by(grupo = if_else(troca, gerencia_troca, "Outras gerências de Vendas"), depois) |>
  summarise(vol = sum(vol), exposicao = sum(hc), .groups = "drop") |>
  mutate(taxa = 100 * vol / exposicao, inf = taxa_ic(vol, exposicao, "inf"), sup = taxa_ic(vol, exposicao, "sup"))
troca_mensal <- vendas |>
  group_by(grupo = if_else(troca, gerencia_troca, "Outras gerências de Vendas"), ano_mes) |>
  summarise(vol = sum(vol), hc = sum(hc), .groups = "drop") |>
  arrange(grupo, ano_mes) |>
  group_by(grupo) |>
  # Média móvel de três meses: a taxa de uma gerência só oscila muito mês a mês.
  mutate(taxa_mm3 = 100 * zoo_soma(vol) / zoo_soma(hc)) |>
  ungroup()
troca_lideranca <- respondentes |>
  filter(gerencia == gerencia_troca) |>
  group_by(depois = data_desligamento >= TROCA) |>
  summarise(n = n(), x = sum(motivo_principal == "Liderança e gestor"), .groups = "drop") |>
  mutate(pct = 100 * x / n, inf = wilson(x, n, "inf"), sup = wilson(x, n, "sup"))
Ver el código R: escala y turno
# Escala 6x1 no turno da noite: participação de "jornada e escala" entre os
# motivos e taxa de saída voluntária, contra as outras combinações.
grupo_jornada <- function(turno, escala) {
  case_when(turno == "Noite" & escala == "6x1" ~ "Noite, 6x1", turno == "Noite" ~ "Noite, outras escalas",
            escala == "6x1" ~ "Dia, 6x1", TRUE ~ "Dia, outras escalas")
}
ordem_jornada <- c("Noite, 6x1", "Noite, outras escalas", "Dia, 6x1", "Dia, outras escalas")
jornada <- respondentes |>
  group_by(grupo = factor(grupo_jornada(turno, escala), ordem_jornada)) |>
  summarise(n = n(), x = sum(motivo_principal == "Jornada e escala"), .groups = "drop") |>
  mutate(pct = 100 * x / n, inf = wilson(x, n, "inf"), sup = wilson(x, n, "sup")) |>
  left_join(pessoa_mes |>
              group_by(grupo = factor(grupo_jornada(turno, escala), ordem_jornada)) |>
              summarise(exposicao = sum(peso), pessoas = n_distinct(id_colaborador), .groups = "drop") |>
              left_join(saidas |> filter(voluntaria) |>
                          count(grupo = factor(grupo_jornada(turno, escala), ordem_jornada), name = "vol"), "grupo") |>
              mutate(taxa_vol = 100 * vol / exposicao, taxa_inf = taxa_ic(vol, exposicao, "inf"),
                     taxa_sup = taxa_ic(vol, exposicao, "sup")),
            "grupo")
Ver el código R: regresiones
# Regressão logística da saída voluntária até 90 dias, entre os admitidos até
# 02/10/2025.
modelo_90 <- glm(vol_90 ~ relevel(factor(grupo), "Demais gerências") * factor(ano_admissao) + noite_6x1 +
                   relevel(factor(faixa_etaria), "35 a 44"),
                 family = binomial, data = coorte_90)
or_90 <- broom::tidy(modelo_90, exponentiate = TRUE, conf.int = TRUE, conf.method = "Wald") |>
  filter(term != "(Intercept)") |>
  select(termo = term, or = estimate, inf = conf.low, sup = conf.high, p = p.value)

# Confundimento: a faixa etária parece importar, mas deixa de ter efeito
# quando o tempo de casa entra no modelo. Unidade: pessoa-mês.
pm <- pessoa_mes |>
  filter(ativo_inicio == 1) |>
  left_join(saidas |> filter(voluntaria) |> transmute(id_colaborador, ano_mes, saiu = 1L),
            c("id_colaborador", "ano_mes")) |>
  mutate(saiu = coalesce(saiu, 0L), faixa_etaria = relevel(factor(faixa_etaria), "35 a 44"),
         tempo_casa = cut(tempo_casa_meses, c(-Inf, 2, 11, 35, Inf),
                          c("Até 3 meses", "3 a 11 meses", "1 a 3 anos", "Mais de 3 anos")))
idade_bruto <- glm(saiu ~ faixa_etaria, family = binomial, data = pm)
idade_ajustado <- glm(saiu ~ faixa_etaria + tempo_casa, family = binomial, data = pm)
or_idade <- bind_rows(
  broom::tidy(idade_bruto, exponentiate = TRUE, conf.int = TRUE, conf.method = "Wald") |> mutate(modelo = "Bruto"),
  broom::tidy(idade_ajustado, exponentiate = TRUE, conf.int = TRUE, conf.method = "Wald") |> mutate(modelo = "Ajustado")) |>
  filter(str_detect(term, "faixa_etaria")) |>
  transmute(modelo, faixa = sub("faixa_etaria", "", term), or = estimate, inf = conf.low, sup = conf.high, p = p.value)
teste_idade_ajustado <- anova(update(idade_ajustado, . ~ tempo_casa), idade_ajustado, test = "LRT")
idade_tempo <- pm |>
  count(faixa_etaria, tempo_casa) |>
  group_by(faixa_etaria) |>
  mutate(pct = 100 * n / sum(n)) |>
  ungroup()
Ver el código R: prioridades
# Prioridades por gerência, em 2025. Alta: a taxa voluntária ou as saídas até
# 90 dias ficam acima da empresa mesmo no limite inferior do intervalo.
# Média: as duas acima da empresa na estimativa, ou um motivo (liderança e
# gestor, jornada e escala) acima da empresa no limite inferior do intervalo.
# Acompanhar: o resto.
ano_ref <- 2025
empresa_vol <- with(filter(anual, ano == ano_ref), taxa_vol)
empresa_90 <- with(filter(noventa_ano, ano_admissao == ano_ref), pct)
empresa_motivo <- function(m) 100 * mean(respondentes$motivo_principal[respondentes$ano == ano_ref] == m)
prior <- pessoa_mes |>
  filter(ano == ano_ref) |>
  group_by(gerencia, unidade) |>
  summarise(exposicao = sum(peso), .groups = "drop") |>
  mutate(hc_medio = exposicao / 12) |>
  left_join(saidas |> filter(ano == ano_ref) |>
              group_by(gerencia) |>
              summarise(vol = sum(voluntaria), saidas = n(), responderam = sum(respondeu == "Sim"),
                        nota_gestor = mean(nota_gestor, na.rm = TRUE), .groups = "drop"), "gerencia") |>
  left_join(respondentes |> filter(ano == ano_ref) |>
              group_by(gerencia) |>
              summarise(resp_vol = n(), lideranca = sum(motivo_principal == "Liderança e gestor"),
                        jornada = sum(motivo_principal == "Jornada e escala"), .groups = "drop"), "gerencia") |>
  left_join(noventa_gerencia |> filter(ano_admissao == ano_ref) |> mutate(gerencia = as.character(gerencia)) |>
              select(gerencia, admitidos, saidas_90 = saidas), "gerencia") |>
  mutate(across(c(vol, saidas, responderam, resp_vol, lideranca, jornada, admitidos, saidas_90), \(x) coalesce(x, 0L)),
         taxa_vol = 100 * vol / exposicao, taxa_inf = taxa_ic(vol, exposicao, "inf"),
         taxa_sup = taxa_ic(vol, exposicao, "sup"),
         pct_90 = 100 * saidas_90 / admitidos, pct_90_inf = wilson(saidas_90, admitidos, "inf"),
         pct_90_sup = wilson(saidas_90, admitidos, "sup"),
         resposta = 100 * responderam / saidas,
         pct_lideranca = 100 * lideranca / resp_vol, lid_inf = wilson(lideranca, resp_vol, "inf"),
         pct_jornada = 100 * jornada / resp_vol, jor_inf = wilson(jornada, resp_vol, "inf"),
         excesso = vol - exposicao * empresa_vol / 100,
         sinal_lideranca = resp_vol >= MINIMO & lid_inf > empresa_motivo("Liderança e gestor"),
         sinal_jornada = resp_vol >= MINIMO & jor_inf > empresa_motivo("Jornada e escala"),
         alta = taxa_inf > empresa_vol | pct_90_inf > empresa_90,
         media = !alta & ((taxa_vol > empresa_vol & pct_90 > empresa_90) | sinal_lideranca | sinal_jornada),
         prioridade = case_when(alta ~ "Alta", media ~ "Média", TRUE ~ "Acompanhar"),
         estimativa = !alta & taxa_vol > empresa_vol & pct_90 > empresa_90) |>
  # Destaques do cruzamento motivo × gerência (2024 e 2025) também viram sinal,
  # mesmo quando não mudam a prioridade.
  left_join(residuos |> filter(destaque, residuo > 0) |>
              group_by(gerencia) |>
              summarise(motivos_residuo = paste(motivo, collapse = "; "), .groups = "drop"), "gerencia") |>
  mutate(sinais = pmap_chr(list(taxa_inf > empresa_vol, pct_90_inf > empresa_90, estimativa, sinal_lideranca,
                                sinal_jornada, motivos_residuo),
                           \(a, b, e, l, j, r) {
                             s <- c(if (a) "Taxa voluntária", if (b) "Saídas até 90 dias",
                                    if (e) c("Taxa voluntária (na estimativa)", "Saídas até 90 dias (na estimativa)"),
                                    if (l) "Liderança e gestor", if (j) "Jornada e escala")
                             if (!is.na(r)) {
                               novos <- setdiff(strsplit(r, "; ")[[1]], s)
                               if (length(novos)) s <- c(s, paste(novos, "(cruzamento com a gerência)"))
                             }
                             paste(s, collapse = "; ")
                           })) |>
  arrange(factor(prioridade, c("Alta", "Média", "Acompanhar")), desc(excesso)) |>
  mutate(ordem = row_number())

# CSV para baixar: só agregados; contagens e percentuais de grupos com menos
# de 10 pessoas viram "<10".
# Mesmo formato do CSV da Auditoria: vírgula separa colunas e ponto separa decimais.
fmt <- function(x, d = 1) formatC(x, format = "f", digits = d)
mascara <- function(valor, n, d = 1) if_else(n < MINIMO, "<10", fmt(valor, d))
prioridades_csv <- prior |>
  transmute(ordem, gerencia, unidade, prioridade, sinais = na_if(sinais, ""),
            headcount_medio = fmt(hc_medio, 0),
            saidas_voluntarias = if_else(vol < MINIMO, "<10", as.character(vol)),
            taxa_voluntaria_mensal_pct = fmt(taxa_vol, 2),
            taxa_ic95_inf = fmt(taxa_inf, 2), taxa_ic95_sup = fmt(taxa_sup, 2),
            admitidos = if_else(admitidos < MINIMO, "<10", as.character(admitidos)),
            saidas_ate_90_dias_pct = mascara(pct_90, admitidos), saidas_90_ic95_inf = mascara(pct_90_inf, admitidos),
            saidas_90_ic95_sup = mascara(pct_90_sup, admitidos),
            taxa_resposta_pct = mascara(resposta, saidas),
            lideranca_gestor_pct = mascara(pct_lideranca, resp_vol),
            jornada_escala_pct = mascara(pct_jornada, resp_vol),
            nota_media_gestor = mascara(nota_gestor, responderam))
dir.create("resultados", showWarnings = FALSE)
write_csv(prioridades_csv, "resultados/prioridades_gerencias.csv", na = "")
NotaTablas técnicas
Regresión logística: renuncia hasta los 90 días (1.222 personas contratadas; referencias: demás gerencias, contratación en 2024, día u otras escalas, 35 a 44 años).
| Término | Razón de probabilidades | IC 95% | p |
|---|---|---|---|
| CD Despacho | 1,38 | 0,81 a 2,29 | 0,219 |
| L3 Operaciones | 1,35 | 0,61 a 2,79 | 0,433 |
| Contratación en 2025 | 1,20 | 0,84 a 1,73 | 0,318 |
| Noche, escala 6x1 | 1,47 | 1,02 a 2,09 | 0,037 |
| 18 a 24 años | 1,46 | 0,91 a 2,42 | 0,125 |
| 25 a 34 años | 1,24 | 0,76 a 2,08 | 0,399 |
| 45 años o más | 1,06 | 0,54 a 2,04 | 0,874 |
| CD Despacho × 2025 | 2,30 | 1,15 a 4,66 | 0,019 |
| L3 Operaciones × 2025 | 2,10 | 0,76 a 6,02 | 0,158 |
Rango de edad, sin y con la antigüedad (42.987 personas-mes; referencia: 35 a 44 años).
| Modelo | Rango de edad | Razón de probabilidades | IC 95% | p |
|---|---|---|---|---|
| Solo el rango de edad | 18 a 24 años | 1,60 | 1,33 a 1,94 | < 0,001 |
| Solo el rango de edad | 25 a 34 años | 1,13 | 0,93 a 1,37 | 0,220 |
| Solo el rango de edad | 45 o más años | 0,85 | 0,67 a 1,07 | 0,168 |
| Con la antigüedad | 18 a 24 años | 1,01 | 0,83 a 1,24 | 0,902 |
| Con la antigüedad | 25 a 34 años | 0,92 | 0,76 a 1,12 | 0,412 |
| Con la antigüedad | 45 o más años | 0,86 | 0,67 a 1,09 | 0,208 |
Tasa de respuesta por tipo de salida.
| Grupo | Salidas | Respondieron | Tasa de respuesta (IC 95%) |
|---|---|---|---|
| Involuntarias (despido o fin del período de prueba) | 523 | 199 | 38,0% (34,0% a 42,3%) |
| Voluntarias (renuncia o acuerdo) | 930 | 712 | 76,6% (73,7% a 79,2%) |
Lo que demuestra el caso
- Leer la entrevista junto con lo demás. El motivo declarado, solo, apuntaba al salario; cruzado con la nota al líder y con el motivo secundario, apuntó al liderazgo.
- Mirar la composición, y no solo el total. Una tasa estable escondía más salidas voluntarias y salidas cada vez más tempranas en dos gerencias.
- Comparar con un control. El cambio de líder de la L5 se midió frente a las otras gerencias de Ventas, y no solo frente a su propio pasado.
- Decir lo que los datos no sostienen. El sesgo de respuesta se midió y se corrigió, la edad se descartó como explicación, y ninguna asociación se trató como causa.
- Una base lista para el tablero. Las seis tablas forman un modelo dimensional, que la próxima etapa del caso usa en un tablero de rotación en Power BI.
¿Tu empresa hace entrevistas de salida, pero nadie las lee junto con lo demás?
Cuéntame cómo funciona hoy y te digo qué se puede cruzar.